Le gradient : définition, calcul et interprétation en prépa
Le gradient en maths : définition, dérivées partielles, interprétation géométrique, dérivée directionnelle, coordonnées polaires et usages en physique de prépa.
Virageprépa

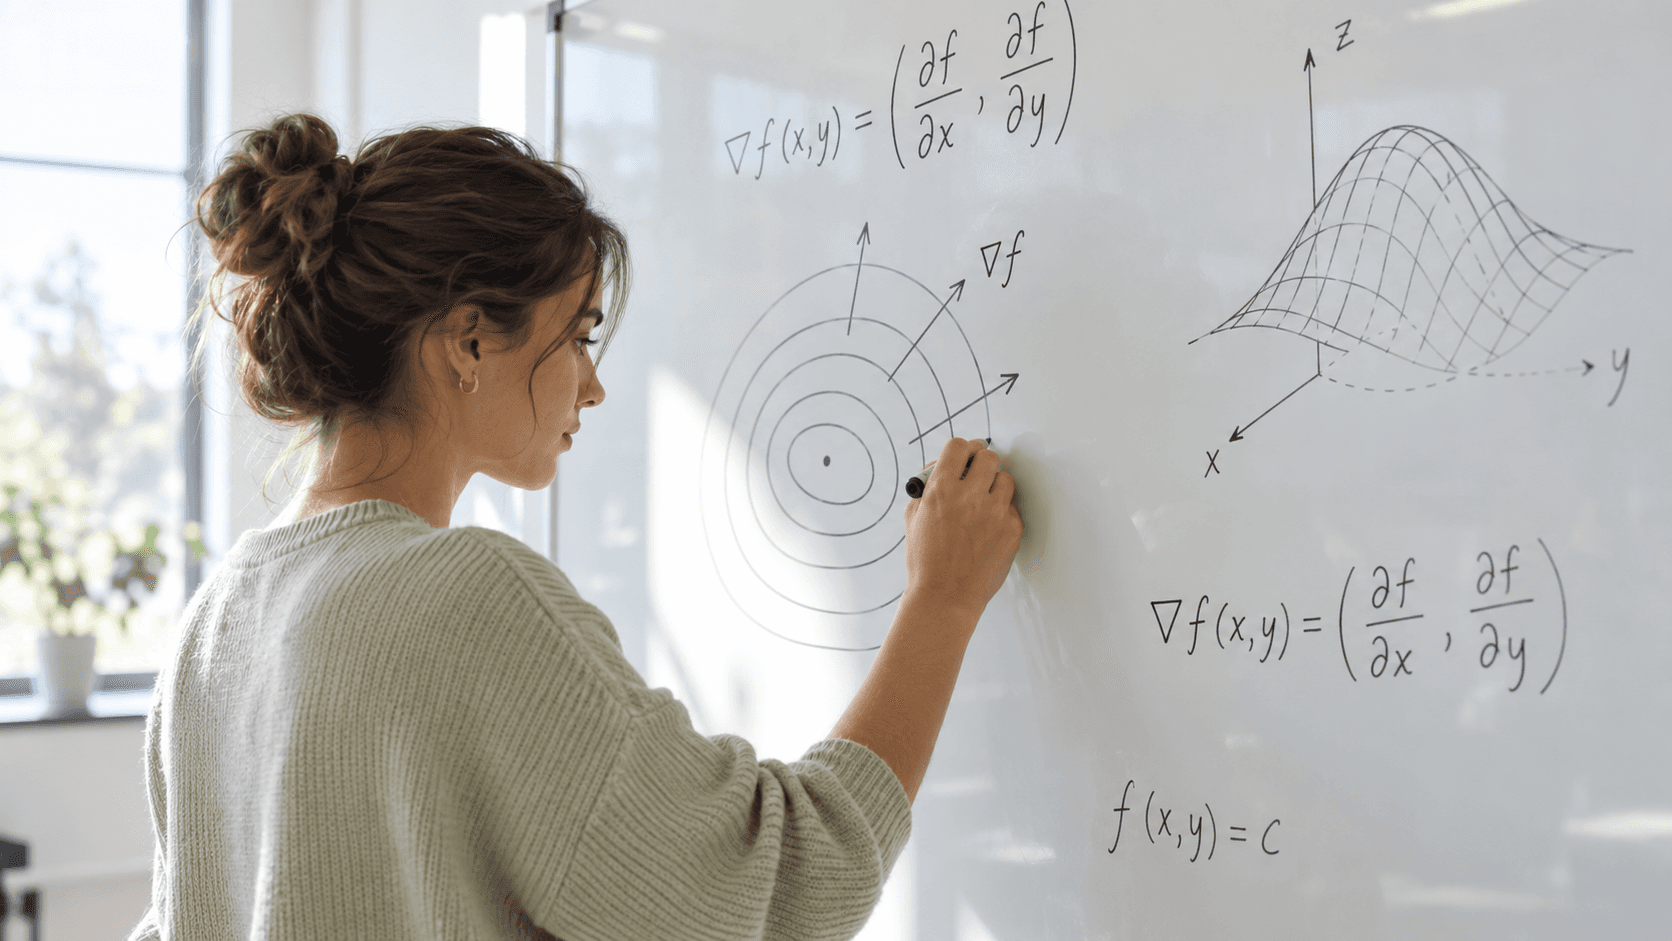
En mathématiques, le gradient d'une fonction de plusieurs variables est le vecteur qui rassemble ses dérivées partielles. On le note ∇f ou grad f. Il pointe dans la direction où la fonction croît le plus vite, et sa norme mesure ce taux de croissance maximal. Le mot désigne aussi un dégradé de couleurs en infographie, et une variation progressive d'une grandeur dans l'espace en géographie, comme un gradient d'altitude. Ce sont des usages distincts. Ici, il s'agit uniquement de la notion mathématique, celle qui apparaît en calcul différentiel et dans presque tous les chapitres de physique de prépa, avec sa définition, son calcul et ses interprétations géométriques.
Ce que le gradient recouvre et ses briques de base
Trois sens différents pour un même mot
Le mot gradient circule dans trois mondes. En infographie, un gradient est un dégradé, une transition continue entre deux couleurs. En géographie et en météorologie, un gradient décrit la variation d'une grandeur par unité de distance, par exemple un gradient thermique vertical.
En mathématiques et en physique, le gradient est un objet vectoriel, construit à partir des dérivées d'une fonction. Les trois idées partagent une intuition commune, celle de variation dans l'espace. Seule la troisième se calcule et se démontre.
Des fonctions à plusieurs entrées
Au lycée, tu manipules des fonctions d'une seule variable, du type x ↦ x². Leur dérivée est un nombre. En prépa, tu rencontres des fonctions qui dépendent de plusieurs variables, par exemple f(x, y) = x² + 3xy.
Une telle fonction associe un nombre réel à un point du plan ou de l'espace. On parle de champ scalaire quand la fonction décrit une grandeur physique, comme une température ou un potentiel. La question devient alors : dans quelle direction cette grandeur varie-t-elle, et de combien ? Une infinité de directions s'offrent à toi depuis un même point, et le gradient résume cette information en un seul vecteur.
La dérivée partielle, définition et calcul
Soit f une fonction de deux variables définie sur un ouvert de ℝ². La dérivée partielle par rapport à x au point (a, b) se définit comme une limite classique.
∂f/∂x (a, b) = lim (h → 0) [ f(a + h, b) − f(a, b) ] / h
Ici f est la fonction étudiée, (a, b) le point d'étude, h un réel qui tend vers 0, et le quotient un taux d'accroissement sans unité propre. Si f est une température en kelvins et x une longueur en mètres, la dérivée partielle s'exprime en K·m⁻¹.
Le calcul est plus simple que la définition. Pour dériver par rapport à x, tu traites y comme une constante, puis tu appliques les règles de dérivation usuelles.
Prends f(x, y) = x²y + sin(y). Alors ∂f/∂x = 2xy, car sin(y) est une constante vis-à-vis de x. Et ∂f/∂y = x² + cos(y), car x² est alors la constante. Tout le calcul du gradient repose sur ce réflexe.
Régularité et classe C¹
Une fonction est dite de classe C¹ sur un ouvert si ses dérivées partielles existent en tout point et y sont continues. Cette hypothèse est le confort standard des énoncés de prépa.
Elle garantit que la fonction est différentiable, donc que le gradient a bien le sens géométrique attendu. L'existence seule des dérivées partielles ne suffit pas à assurer la différentiabilité. Les contre-exemples classiques servent précisément à te le rappeler en colle.
La définition du gradient
Le vecteur des dérivées partielles
Soit f une fonction de classe C¹ sur un ouvert de ℝⁿ. Le gradient de f en un point est le vecteur dont les composantes sont les n dérivées partielles de f en ce point.
∇f = ( ∂f/∂x , ∂f/∂y , ∂f/∂z )
Dans cette écriture, ∇f est un vecteur de ℝ³, et chaque composante est une dérivée partielle de f. Si f est un potentiel en volts et les coordonnées en mètres, chaque composante s'exprime en V·m⁻¹.
Les notations ∇f et grad f
Deux notations dominent. La première utilise le symbole ∇, appelé nabla, dont le nom vient d'une harpe antique de forme triangulaire. La seconde s'écrit grad f, parfois surmontée d'une flèche en physique.
L'opérateur nabla se lit comme un vecteur symbolique de dérivations. Appliqué à un champ scalaire, il donne le gradient. Appliqué à un champ vectoriel par produit scalaire, il donne la divergence. Par produit vectoriel, il donne le rotationnel.
Le lien avec la différentielle
La différentielle de f en un point a est l'application linéaire df(a) qui approche les accroissements de f. Le gradient est le vecteur qui représente cette application linéaire au sens du produit scalaire.
df(a)(h) = ⟨ ∇f(a) , h ⟩
Ici h est un vecteur d'accroissement, ⟨ , ⟩ le produit scalaire canonique, et df(a)(h) la variation approchée de f. Cette identité est la définition rigoureuse du gradient. Elle montre aussi que le gradient dépend du produit scalaire choisi, contrairement à la différentielle.
Interprétation géométrique et dérivée directionnelle
La direction de plus forte croissance
Fixe un point a et un vecteur unitaire u. La dérivée directionnelle de f en a selon u vaut le produit scalaire du gradient par u.
D_u f(a) = ⟨ ∇f(a) , u ⟩ = ‖∇f(a)‖ × cos θ
Ici u est un vecteur de norme 1, θ l'angle entre ∇f(a) et u, et ‖∇f(a)‖ la norme du gradient. L'expression est maximale quand cos θ vaut 1, donc quand u pointe dans le sens du gradient.
La norme comme taux maximal
Le même calcul donne la valeur de ce maximum. Le taux de variation le plus grand possible vaut exactement ‖∇f(a)‖.
À l'opposé, la direction de plus forte décroissance est celle de −∇f(a). Cette remarque est le fondement de la descente de gradient en optimisation. Entre les deux, toutes les valeurs intermédiaires sont atteintes.
Orthogonalité aux lignes de niveau
Quand cos θ vaut 0, la dérivée directionnelle est nulle. La fonction ne varie pas, au premier ordre, dans cette direction. Or les lignes de niveau sont exactement les courbes le long desquelles f reste constante.
Le gradient est donc orthogonal en chaque point à la ligne de niveau qui y passe. En dimension trois, il est orthogonal à la surface de niveau. Cette propriété fournit un vecteur normal immédiat, très utile pour écrire l'équation d'un plan tangent.
Lecture sur une carte
L'image du relief aide à fixer l'idée. Sur une carte topographique, les courbes de niveau relient les points de même altitude. Le gradient de l'altitude pointe perpendiculairement à ces courbes, vers le haut de la pente.
Sa norme est d'autant plus grande que les courbes sont resserrées. Un gradient nul signale un plat, un sommet ou un col. Cette lecture visuelle se transpose directement aux champs de température et de potentiel.
Un exemple entièrement résolu
L'énoncé
Considère la fonction f définie sur ℝ² par f(x, y) = x²y + 3y². On demande le gradient de f au point A(2, 1), puis la dérivée directionnelle de f en A dans la direction du vecteur v = (3, 4).
On demande enfin la direction de plus forte croissance en A et la valeur du taux correspondant. La fonction est polynomiale, donc indéfiniment dérivable sur ℝ². Toutes les opérations sont légitimes.
Étapes 1 et 2, les dérivées partielles puis le gradient
On dérive par rapport à x en traitant y comme une constante. Le terme x²y donne 2xy, et le terme 3y² donne 0.
∂f/∂x (x, y) = 2xy
On dérive ensuite par rapport à y en traitant x comme une constante. Le terme x²y donne x², et le terme 3y² donne 6y.
∂f/∂y (x, y) = x² + 6y
Dans ces deux expressions, x et y sont les variables réelles de la fonction, sans unité imposée ici.
On remplace x par 2 et y par 1 dans chaque dérivée partielle. Le premier calcul donne 2 × 2 × 1 = 4. Le second donne 2² + 6 × 1 = 4 + 6 = 10.
∇f(2, 1) = (4 , 10)
Le gradient en A est donc le vecteur de composantes 4 et 10. Sa norme vaut √(4² + 10²) = √116 = 2√29, soit environ 10,77.
Étape 3, la dérivée directionnelle en A
Le vecteur v = (3, 4) n'est pas unitaire. Sa norme vaut √(3² + 4²) = 5. On le normalise donc avant tout produit scalaire.
u = v / ‖v‖ = (3/5 , 4/5)
Ici u est le vecteur unitaire colinéaire à v et de même sens. On applique ensuite la formule du produit scalaire avec le gradient.
D_u f(2, 1) = 4 × 3/5 + 10 × 4/5 = 12/5 + 40/5 = 52/5 = 10,4
Le taux de variation de f en A dans la direction u vaut donc 10,4. La valeur est positive, donc f croît dans cette direction.
Étape 4, la lecture géométrique
La direction de plus forte croissance en A est celle du gradient lui-même, portée par le vecteur unitaire (4, 10) / (2√29). Le taux correspondant vaut 2√29, soit environ 10,77.
On vérifie la cohérence du résultat précédent. La valeur 10,4 obtenue selon u est inférieure à 10,77, comme l'impose l'inégalité de Cauchy-Schwarz. Le vecteur v est donc presque, mais pas exactement, aligné sur le gradient. Enfin, la tangente à la ligne de niveau passant par A est orthogonale à (4, 10), donc dirigée par (10, −4) ou (−10, 4).
Points critiques, extrema et matrice hessienne
La condition nécessaire du premier ordre
Soit f de classe C¹ sur un ouvert U. Si f admet un extremum local en un point a intérieur à U, alors ∇f(a) est le vecteur nul. Un tel point s'appelle point critique.
La réciproque est fausse. Un gradient nul n'entraîne pas un extremum, comme le montre la fonction f(x, y) = x² − y² à l'origine. Ce point est un point col, ou point selle : la fonction y croît selon un axe et décroît selon l'autre.
La matrice hessienne
Pour trancher, on passe à l'ordre deux. La matrice hessienne de f en a rassemble les dérivées partielles secondes. Pour deux variables, elle s'écrit avec ∂²f/∂x², ∂²f/∂x∂y, ∂²f/∂y∂x et ∂²f/∂y².
Le théorème de Schwarz assure que les deux dérivées croisées sont égales dès que f est de classe C². La hessienne est alors symétrique, donc diagonalisable en base orthonormée. Ses valeurs propres livrent la nature du point critique.
Lire la nature d'un point critique
La lecture est simple sur les valeurs propres de la hessienne au point critique. Toutes strictement positives indiquent un minimum local. Toutes strictement négatives indiquent un maximum local.
Des valeurs propres de signes contraires indiquent un point col. Une valeur propre nulle laisse le cas indéterminé au second ordre, et demande une étude directe. En pratique, pour deux variables, on utilise souvent le déterminant et la trace de la hessienne.
Les expressions selon le système de coordonnées
Pourquoi changer de coordonnées
Un problème à symétrie de révolution se traite mal en coordonnées cartésiennes. Le potentiel d'une charge ponctuelle ne dépend que de la distance au centre. Les coordonnées sphériques rendent alors l'écriture immédiate.
Le gradient s'exprime différemment dans chaque système. Les facteurs supplémentaires viennent des longueurs élémentaires associées à chaque coordonnée angulaire. Ces expressions sont à connaître ou à savoir retrouver, selon ta filière.
Le tableau des expressions
Système | Coordonnées | Expression de ∇f | Longueur élémentaire |
|---|---|---|---|
Cartésiennes (plan) | (x, y) | (∂f/∂x) eₓ + (∂f/∂y) e_y | dx, dy |
Cartésiennes (espace) | (x, y, z) | (∂f/∂x) eₓ + (∂f/∂y) e_y + (∂f/∂z) e_z | dx, dy, dz |
Polaires | (r, θ) | (∂f/∂r) e_r + (1/r)(∂f/∂θ) e_θ | dr, r dθ |
Cylindriques | (r, θ, z) | (∂f/∂r) e_r + (1/r)(∂f/∂θ) e_θ + (∂f/∂z) e_z | dr, r dθ, dz |
Sphériques | (r, θ, φ) | (∂f/∂r) e_r + (1/r)(∂f/∂θ) e_θ + (1/(r sin θ))(∂f/∂φ) e_φ | dr, r dθ, r sin θ dφ |
Dans ce tableau, f est le champ scalaire étudié, r la distance, θ et φ des angles en radians, et e_r, e_θ, e_φ les vecteurs de la base locale orthonormée. Les conventions d'angles varient selon les ouvrages, donc vérifie toujours celle de ton énoncé.
La règle mnémotechnique
Une relation unique résume tout le tableau. Le gradient est le vecteur tel que la variation élémentaire de f s'écrive comme un produit scalaire.
df = ⟨ ∇f , dOM ⟩
Ici df est la variation élémentaire de f, et dOM le vecteur déplacement élémentaire. En sphériques, dOM s'écrit dr e_r + r dθ e_θ + r sin θ dφ e_φ. Les facteurs 1/r et 1/(r sin θ) apparaissent alors mécaniquement, sans rien apprendre par cœur.
Les usages en physique et en optimisation
Force dérivant d'un potentiel
En mécanique, une force conservative se déduit d'une énergie potentielle par un gradient, au signe près.
F = −∇E_p
Ici F est la force en newtons, E_p l'énergie potentielle en joules, et les dérivations portent sur des longueurs en mètres. Le signe moins traduit un fait simple : la force pousse vers les énergies potentielles plus basses. Une bille roule vers le bas de la vallée, pas vers le sommet.
Champ électrique et potentiel
L'électrostatique suit la même structure. Le champ électrique dérive du potentiel électrostatique par la même relation formelle.
E = −∇V
Ici E est le champ électrique en V·m⁻¹ et V le potentiel en volts. Les lignes de champ sont donc orthogonales aux surfaces équipotentielles, puisque ce sont les surfaces de niveau de V. Ce résultat se déduit directement de la propriété d'orthogonalité vue plus haut.
Lois de transport, Fourier et Fick
Les phénomènes de diffusion s'écrivent aussi avec un gradient. La loi de Fourier relie le vecteur densité de flux thermique au gradient de température.
j_Q = −λ ∇T
Ici j_Q est la densité de flux thermique en W·m⁻², λ la conductivité thermique en W·m⁻¹·K⁻¹, et T la température en kelvins. La loi de Fick a la même forme pour la matière : j = −D ∇c, avec D le coefficient de diffusion en m²·s⁻¹ et c la concentration en mol·m⁻³. Dans les deux cas, le signe moins dit que le transport se fait des zones hautes vers les zones basses.
La descente de gradient
En optimisation numérique, on cherche le minimum d'une fonction sans le résoudre exactement. La descente de gradient exploite le fait que −∇f indique la plus forte décroissance.
x_(k+1) = x_k − η ∇f(x_k)
Ici x_k est le point à l'étape k, η un réel positif appelé pas ou taux d'apprentissage, et ∇f(x_k) le gradient au point courant. On répète l'opération jusqu'à stabilisation. Cette méthode est au cœur de l'entraînement des réseaux de neurones, où f mesure une erreur de prédiction.
Erreurs classiques et place au programme
Confondre gradient et dérivée
L'erreur la plus fréquente consiste à écrire un gradient comme un nombre. Le gradient est un vecteur, toujours. Une égalité du type ∇f = 2xy est donc fausse par nature.
Autre confusion voisine : oublier que le gradient dépend du point. L'écriture ∇f(a) désigne un vecteur particulier, celui associé au point a. Le champ ∇f, lui, est une fonction du point.
Oublier de normaliser la direction
Dans les calculs de dérivée directionnelle, le vecteur directeur doit être unitaire. Sans normalisation, le résultat change avec la longueur du vecteur choisi, ce qui n'a aucun sens physique.
Une deuxième maladresse consiste à oublier le signe moins dans les relations de physique. F = ∇E_p au lieu de F = −∇E_p inverse le sens de la force. Le correcteur le repère immédiatement.
Négliger les hypothèses de régularité
En colle, la question porte souvent sur les hypothèses. Confondre existence des dérivées partielles et différentiabilité est une faute de cours. La classe C¹ doit être vérifiée ou invoquée avant d'utiliser les propriétés géométriques.
De même, le théorème de Schwarz sur les dérivées croisées demande la classe C². L'appliquer sans justification fait perdre des points sur une question de rédaction.
Où la notion apparaît dans les programmes
Les programmes des classes préparatoires scientifiques sont publiés par le ministère au Bulletin officiel, avec une refonte entrée en vigueur pour les premières années à la rentrée 2021. En physique, les outils mathématiques de première année introduisent le gradient d'un champ scalaire, en PCSI comme en MPSI.
En mathématiques, le calcul différentiel à plusieurs variables se développe surtout en deuxième année, en MP, PC, PSI, PT et MPI, ainsi qu'en ECG pour l'optimisation. Les intitulés exacts et le niveau d'exigence varient selon la voie, donc consulte la page de ton programme sur le site du ministère. Aux concours, le gradient intervient rarement comme sujet isolé, et très souvent comme outil, en thermodynamique, en électromagnétisme et en mécanique.
Conclusion
Le gradient tient dans une phrase : c'est le vecteur des dérivées partielles, il pointe vers la plus forte croissance, sa norme donne le taux maximal, et il est orthogonal aux lignes de niveau. Tout le reste en découle, de la dérivée directionnelle à la recherche d'extrema.
Ce qui fait la différence en copie, ce n'est pas la formule mais la rigueur autour d'elle. Vérifie la régularité, normalise tes directions, surveille les signes en physique, et sache retrouver les expressions en polaires depuis df = ⟨ ∇f , dOM ⟩ plutôt que de les réciter. Un exemple calculé en entier vaut mieux que dix formules recopiées.
Travaille tes concours avec un mentor et transforme ces connaissances en points, avec ViragePrépa.




Cet article vous concerne ? Parlons-en 15 minutes.
On analyse la situation de l'élève et on vous dit franchement où il peut viser. Gratuit · Sans engagement · 7j/7


