La loi normale : définition, calcul et usage en prépa
Loi normale : densité, courbe de Gauss, loi centrée réduite N(0,1), table de Φ, valeurs à 1σ, 2σ et 3σ, et un calcul entièrement résolu pour la prépa.
ViragePrépa

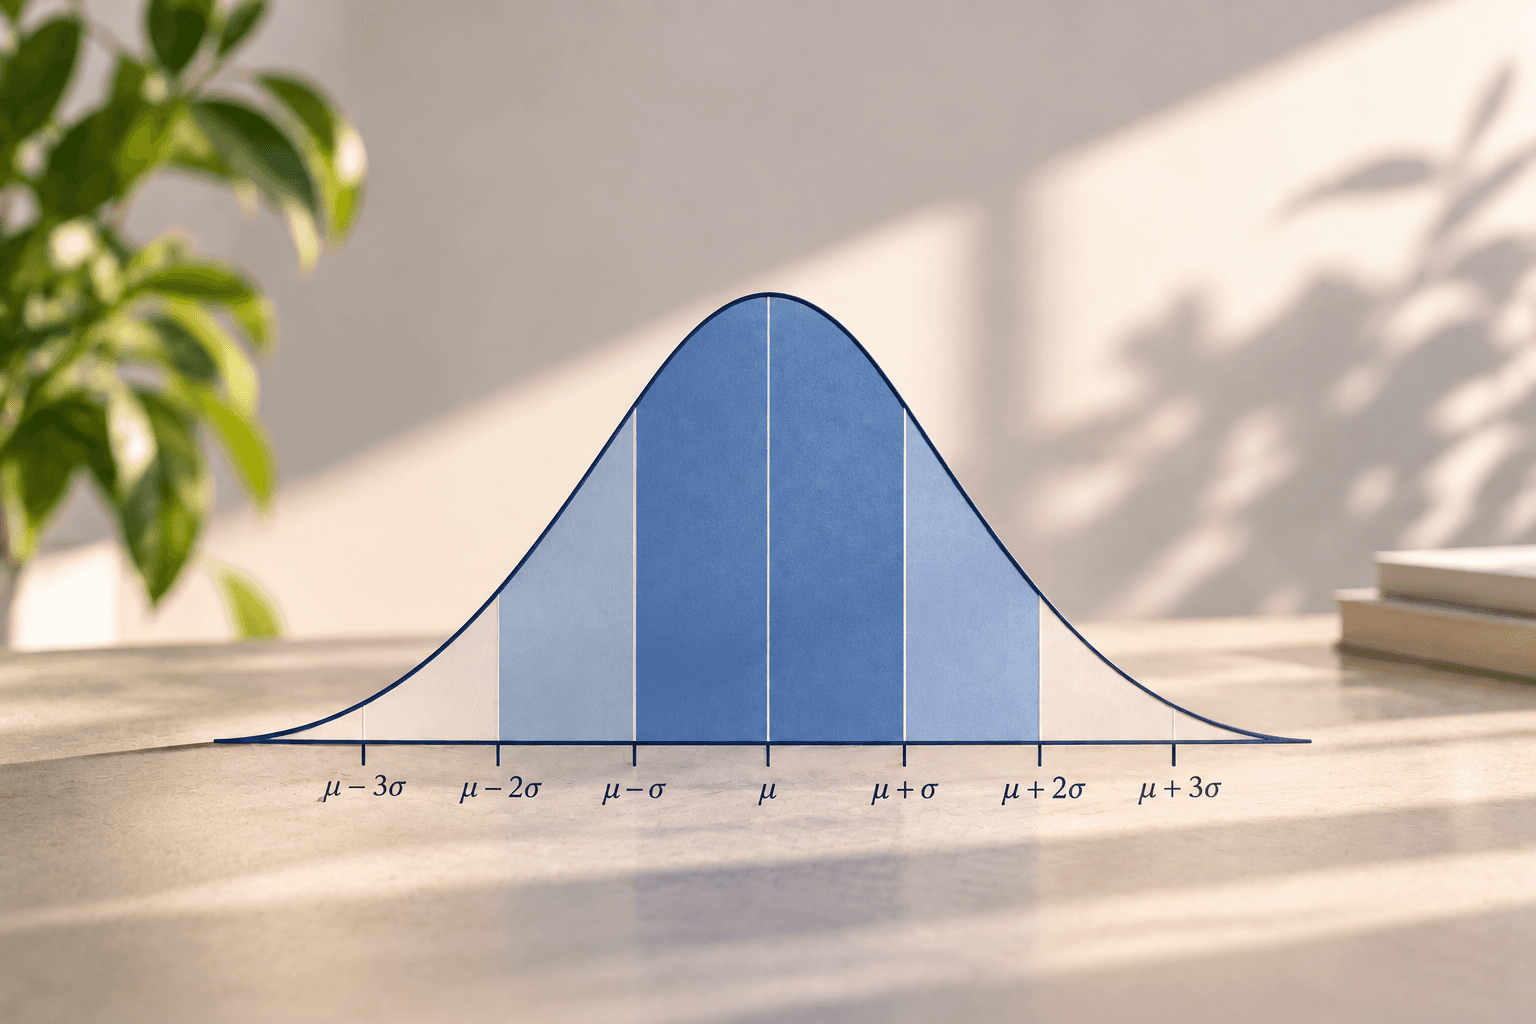
La loi normale est la loi de probabilité continue dont la densité dessine la courbe en cloche d'expression f(x) = (1/(σ√(2π)))·exp(-(x-μ)²/(2σ²)). Elle dépend de deux paramètres seulement, la moyenne μ et l'écart type σ. Elle modélise une grandeur qui fluctue autour d'une valeur centrale, avec des écarts d'autant plus rares qu'ils sont grands. Sa courbe est symétrique, l'aire sous cette courbe vaut 1, et toute loi normale se ramène à la loi normale centrée réduite N(0,1) par le changement de variable Z = (X - μ)/σ. C'est ce passage qui permet de lire une probabilité dans une table ou sur une calculatrice. Le théorème central limite explique ensuite pourquoi cette loi revient dans presque tous les modèles.
Ce que recouvre la loi normale
Une loi continue, et non une loi de comptage
Une loi binomiale compte des succès. Ses valeurs sont des entiers, et chaque valeur porte une probabilité propre. La loi normale décrit au contraire une grandeur qui peut prendre n'importe quelle valeur réelle, comme une masse ou une durée.
Pour une telle grandeur, la probabilité d'une valeur isolée est nulle. On écrit P(X = a) = 0 pour tout réel a. Seules les probabilités d'intervalles ont un sens. Conséquence pratique : tu peux écrire P(X ≤ a) = P(X < a) sans précaution.
Pourquoi cette loi apparaît partout
La loi normale s'impose comme limite. Dès qu'une grandeur résulte de l'accumulation de nombreux effets petits et indépendants, sa loi se rapproche d'une loi normale. Le théorème central limite donne à cette observation un énoncé précis.
Les erreurs de mesure en physique en donnent un exemple immédiat. Chaque mesure subit une foule de perturbations minuscules, dont la somme se comporte comme une variable normale. Le nom de courbe de Gauss renvoie aux travaux de Carl Friedrich Gauss sur la théorie des erreurs.
Les notations à fixer une fois pour toutes
On note X ~ N(μ, σ²) pour dire que X suit la loi normale d'espérance μ et de variance σ². Attention : le second paramètre est la variance, donc le carré de l'écart type. Certains ouvrages écrivent N(μ, σ). Vérifie la convention de ton cours avant tout calcul.
Le cas μ = 0 et σ = 1 porte un nom propre : la loi normale centrée réduite, notée N(0,1). Sa variable est presque toujours notée Z, sa densité φ et sa fonction de répartition Φ.
La définition par la densité
La formule de la densité
Voici l'objet central du chapitre. Tout le reste en découle.
f(x) = (1/(σ√(2π)))·exp(-(x-μ)²/(2σ²)), pour tout x ∈ ℝ
Dans cette expression, x est la variable réelle, homogène à la grandeur modélisée. Le réel μ est l'espérance, dans la même unité que x, par exemple en grammes. Le réel σ > 0 est l'écart type, également dans l'unité de x. La constante π vaut environ 3,14159 et exp désigne la fonction exponentielle.
La densité f(x) s'exprime, elle, en inverse de l'unité de x.
Pour la loi normale centrée réduite, la formule se réduit nettement.
φ(t) = (1/√(2π))·exp(-t²/2), pour tout t ∈ ℝ
Ici t est un réel sans dimension, puisque le centrage et la réduction ont effacé les unités. Le facteur 1/√(2π) vaut environ 0,39894. C'est aussi la valeur maximale de φ, atteinte en t = 0.
Ce que veut dire « être une densité »
Une densité de probabilité est une fonction continue, positive, dont l'intégrale sur ℝ vaut 1. La positivité de f est immédiate. La condition d'intégrale unité repose sur une intégrale célèbre.
∫ exp(-t²/2) dt = √(2π), l'intégrale portant sur ℝ tout entier
Ce calcul se mène par passage en coordonnées polaires, et c'est un exercice classique de première année de prépa. Une fois la densité admise, les probabilités deviennent des aires.
P(a ≤ X ≤ b) = ∫ f(x) dx, l'intégrale allant de a à b
Les bornes a et b sont deux réels dans l'unité de X, avec a ≤ b. Le résultat est un nombre sans unité, compris entre 0 et 1. C'est la définition même de la probabilité d'un intervalle pour une variable à densité.
Le rôle des deux paramètres
Le paramètre μ localise la courbe. Il donne l'abscisse du sommet et l'axe de symétrie. Faire varier μ translate la courbe horizontalement, sans la déformer.
Le paramètre σ règle la dispersion. Un petit σ donne une cloche haute et étroite. Un grand σ donne une cloche basse et étalée. La hauteur du sommet vaut 1/(σ√(2π)), donc elle décroît quand σ augmente.
Les propriétés de la courbe de Gauss
La symétrie autour de μ
La densité vérifie f(μ + h) = f(μ - h) pour tout réel h. La courbe est donc symétrique par rapport à la droite d'équation x = μ.
Tu obtiens d'abord P(X ≤ μ) = P(X ≥ μ) = 0,5. La médiane coïncide avec la moyenne et avec le mode. Tu obtiens ensuite, pour la loi centrée réduite, la relation Φ(-t) = 1 - Φ(t). C'est pourquoi les tables historiques ne donnaient que les valeurs positives.
Les points d'inflexion en μ ± σ
La dérivée seconde de la densité s'annule exactement en deux points. Un calcul direct donne f''(x) = f(x)·((x-μ)² - σ²)/σ⁴. Le signe change en x = μ - σ et en x = μ + σ.
La courbe est donc concave sur ]μ - σ, μ + σ[ et convexe à l'extérieur. L'écart type se lit ainsi graphiquement, comme la distance horizontale entre le sommet et un point d'inflexion. C'est une question de colle fréquente.
L'aire totale, l'espérance et la variance
L'aire sous la courbe vaut 1 sur ℝ entier, ce qui traduit la certitude de l'événement total. Tu passes donc de P(X ≥ a) à 1 - P(X ≤ a) sans autre justification. La densité tend vers 0 en -∞ et en +∞, et la décroissance en exp(-x²) rend les valeurs éloignées de μ très improbables.
Les deux moments se calculent par intégration, et les résultats sont ceux que les notations annonçaient.
E(X) = μ et V(X) = σ², donc σ(X) = σ
Ici E(X) désigne l'espérance, dans l'unité de X, et V(X) la variance, dans le carré de cette unité. L'écart type σ(X) revient à l'unité de X. Ces trois quantités caractérisent complètement la loi dans le cas normal, situation très particulière.
La loi normale centrée réduite et le centrage-réduction
La loi N(0,1) comme loi pivot
La loi N(0,1) joue le rôle d'étalon. Une seule table, une seule fonction, et toutes les lois normales deviennent accessibles. Son espérance vaut 0 et sa variance vaut 1. Sa densité φ est paire, son maximum 0,39894 est atteint en 0, et ses points d'inflexion sont en -1 et 1.
Le changement de variable Z = (X - μ)/σ
Le résultat qui fait tout fonctionner s'énonce en une ligne.
Si X ~ N(μ, σ²), alors Z = (X - μ)/σ suit la loi N(0,1)
X est la variable initiale dans son unité, μ son espérance dans la même unité, σ son écart type strictement positif. La variable Z est sans dimension, puisque numérateur et dénominateur portent la même unité. On centre en retranchant μ, puis on réduit en divisant par σ.
La réciproque est utile aussi : si Z ~ N(0,1), alors X = μ + σZ suit la loi N(μ, σ²).
La fonction de répartition Φ
La fonction de répartition de la loi N(0,1) se note Φ. Sa définition est une intégrale.
Φ(t) = ∫ φ(u) du, l'intégrale allant de -∞ à t
Le réel t est le seuil considéré, sans unité. La valeur Φ(t) est la probabilité P(Z ≤ t), donc un nombre de l'intervalle ]0, 1[. Cette fonction est strictement croissante, continue et de classe C∞ sur ℝ.
Un point mérite d'être souligné. Φ n'a pas d'expression à l'aide des fonctions usuelles, car exp(-t²/2) n'admet pas de primitive élémentaire. D'où le recours à une table ou à un algorithme numérique.
Lire une table ou interroger une calculatrice
Une table de la loi normale donne Φ(t) pour t positif. Tu lis l'unité et le premier chiffre décimal en ligne, le deuxième chiffre décimal en colonne. Pour un t négatif, tu appliques Φ(-t) = 1 - Φ(t).
Les calculatrices font le même travail sans table, sous les noms normalFRép, normalcdf ou NormalCD selon les modèles. Elles prennent les deux bornes, puis μ et σ. Le problème inverse porte les noms FracNormale, invNorm ou InvNormalCD.
Les valeurs de référence à connaître
Les intervalles à 1σ, 2σ et 3σ
Trois résultats se retiennent par cœur. Ils donnent la probabilité que X s'écarte de μ de moins d'un, deux ou trois écarts types.
P(μ - σ ≤ X ≤ μ + σ) ≈ 0,6827, P(μ - 2σ ≤ X ≤ μ + 2σ) ≈ 0,9545, P(μ - 3σ ≤ X ≤ μ + 3σ) ≈ 0,9973
Chaque membre de gauche est une probabilité sans unité, et les bornes sont dans l'unité de X. Ces trois nombres découlent de la relation 2Φ(k) - 1 appliquée à k = 1, 2 et 3. On parle de règle des trois sigmas : un écart supérieur à 3σ survient environ trois fois sur mille. Elle sert de repère d'alerte en contrôle industriel, non de preuve.
Les quantiles usuels dans l'autre sens
Le problème se pose aussi à l'envers. On fixe une probabilité, et on cherche l'écart correspondant. Les valeurs 1,645, 1,96 et 2,576 reviennent alors sans cesse. La plus connue est 1,96 : elle vérifie 2Φ(1,96) - 1 ≈ 0,95.
Tableau récapitulatif
Les valeurs suivantes sont arrondies à quatre décimales. Le tableau se relit dans les deux sens, de l'écart vers la probabilité ou l'inverse.
Écart k (en nombre de σ) | Φ(k) = P(Z ≤ k) | P(-k ≤ Z ≤ k) | Interprétation courante |
|---|---|---|---|
0 | 0,5000 | 0 | médiane, sommet de la courbe |
0,5 | 0,6915 | 0,3829 | environ 38 % de la masse |
1 | 0,8413 | 0,6827 | point d'inflexion, règle 1σ |
1,2816 | 0,9000 | 0,8000 | intervalle centré à 80 % |
1,645 | 0,9500 | 0,9000 | intervalle centré à 90 % |
1,96 | 0,9750 | 0,9500 | intervalle centré à 95 % |
2 | 0,9772 | 0,9545 | règle 2σ |
2,576 | 0,9950 | 0,9900 | intervalle centré à 99 % |
3 | 0,9987 | 0,9973 | règle 3σ |
4 | 1,0000 | 0,9999 | événement quasi impossible |
Un calcul de probabilité entièrement résolu
L'énoncé
Une chaîne remplit des pots de confiture. La masse nette X d'un pot, en grammes, suit une loi normale d'espérance μ = 250 g et d'écart type σ = 8 g. On note X ~ N(250, 64), puisque le second paramètre est la variance. Quelle est la probabilité qu'un pot pèse entre 242 g et 265 g, puis qu'il dépasse 265 g ?
Étape 1 : écrire l'événement et centrer
On cherche d'abord P(242 ≤ X ≤ 265). On introduit Z = (X - 250)/8, qui suit la loi N(0,1). Encadrer X revient à encadrer Z, puisque la transformation est affine croissante.
242 ≤ X ≤ 265 ⇔ (242 - 250)/8 ≤ Z ≤ (265 - 250)/8
Le membre central est la variable centrée réduite, sans unité. Les deux bornes sont des écarts exprimés en nombre d'écarts types. Cette équivalence ne modifie pas l'événement, seulement son écriture.
Étape 2 : calculer les cotes réduites, puis conclure
Le calcul des bornes est purement numérique. On obtient (242 - 250)/8 = -1 et (265 - 250)/8 = 1,875. L'événement devient -1 ≤ Z ≤ 1,875, et la probabilité cherchée s'écrit Φ(1,875) - Φ(-1).
La table donne Φ(1,875) ≈ 0,9696 et Φ(1) ≈ 0,8413, d'où Φ(-1) = 1 - 0,8413 = 0,1587.
P(242 ≤ X ≤ 265) = Φ(1,875) - Φ(-1) ≈ 0,9696 - 0,1587 ≈ 0,8109
Le résultat est une probabilité sans unité. Elle vaut environ 0,811, soit près de 81,1 %. Autrement dit, environ huit pots sur dix ont une masse dans cet intervalle.
Étape 3 : la seconde question et le contrôle de vraisemblance
Pour P(X > 265), on réutilise la cote 1,875 déjà calculée. On écrit P(X > 265) = 1 - Φ(1,875) ≈ 0,0304. Environ 3 % des pots dépassent donc 265 g.
Un contrôle rapide confirme l'ordre de grandeur. La borne 242 g est à -1σ et la borne 265 g à +1,875σ. Le résultat doit donc dépasser 0,6827 sans atteindre 0,9545.
Stabilité par somme, théorème central limite et approximations
La stabilité par somme de variables indépendantes
La famille des lois normales est stable par addition. Ce résultat est rare et précieux.
Si X ~ N(μ₁, σ₁²) et Y ~ N(μ₂, σ₂²) sont indépendantes, alors X + Y ~ N(μ₁ + μ₂, σ₁² + σ₂²)
Les espérances μ₁ et μ₂ sont dans l'unité commune des deux variables, les variances σ₁² et σ₂² dans le carré de cette unité. Retiens que les variances s'ajoutent, jamais les écarts types.
Plus généralement, toute combinaison linéaire de variables normales indépendantes reste normale. Si les Xᵢ sont indépendantes de loi N(μ, σ²), leur somme Sₙ suit N(nμ, nσ²). Leur moyenne empirique suit alors N(μ, σ²/n), ce qui fait apparaître le facteur σ/√n.
Le théorème central limite
Ce théorème ne suppose plus que les variables initiales soient normales. C'est ce qui lui donne sa portée.
Si les Xᵢ sont indépendantes, de même loi, d'espérance μ et de variance σ² finie non nulle, alors (Sₙ - nμ)/(σ√n) converge en loi vers N(0,1)
Ici Sₙ = X₁ + … + Xₙ est la somme des n premières variables, dans leur unité commune, et le quotient est sans dimension. La convergence en loi signifie que la fonction de répartition de ce quotient tend vers Φ en tout point réel.
Le théorème répond à la question du « pourquoi partout ». Quelle que soit la loi de départ, pourvu qu'elle ait une variance finie, la somme normalisée devient gaussienne. Aleksandr Liapounov en a donné une forme rigoureuse au tournant du vingtième siècle.
L'approximation de la loi binomiale
Si X ~ B(n, p), alors X est une somme de n variables de Bernoulli indépendantes. Son espérance vaut np et sa variance np(1-p).
Pour n grand, (X - np)/√(np(1-p)) suit approximativement la loi N(0,1)
Le nombre n est le nombre d'épreuves et p la probabilité de succès, tous deux sans unité. Ce résultat porte le nom de théorème de de Moivre-Laplace. Il précède le théorème central limite général et s'en déduit comme cas particulier.
La pratique ajoute des règles d'usage, qui ne sont pas des théorèmes. On vérifie souvent que n ≥ 30, np ≥ 5 et n(1-p) ≥ 5. Une correction de continuité améliore le résultat : on remplace P(X ≤ k) par Φ((k + 0,5 - np)/√(np(1-p))).
Un exemple chiffré fixe les idées. Pour n = 200 et p = 0,4, on a np = 80 et √(np(1-p)) ≈ 6,928. L'approximation corrigée donne P(X ≤ 90) ≈ Φ(1,516) ≈ 0,9352, contre 0,9345 pour le calcul binomial exact.
L'approximation de la loi de Poisson
Si Y suit une loi de Poisson de paramètre λ, son espérance et sa variance valent toutes deux λ.
Pour λ grand, (Y - λ)/√λ suit approximativement la loi N(0,1)
Le paramètre λ est un nombre moyen d'occurrences sur une période donnée, donc sans unité. La justification combine la stabilité de la loi de Poisson par somme et le théorème central limite. Les règles d'usage évoquent λ ≥ 20, sans caractère normatif.
Usages en statistique, erreurs classiques et place au programme
Intervalle de confiance et test
La loi normale sert de socle à l'inférence statistique. Considère n observations indépendantes, de moyenne empirique X̄, issues d'une loi d'espérance μ inconnue et d'écart type σ connu.
Intervalle de confiance au niveau 1 - α : [X̄ - z·σ/√n ; X̄ + z·σ/√n], avec z tel que 2Φ(z) - 1 = 1 - α
La moyenne empirique X̄ est dans l'unité des observations, σ aussi, et n est un entier sans unité. Le quantile z est sans dimension : 1,96 pour un niveau de 95 %, 2,576 pour 99 %. La largeur de l'intervalle décroît en 1/√n.
Le raisonnement de test suit la même logique. On formule une hypothèse sur μ, on calcule une statistique centrée réduite, puis on la compare à un seuil lu sur Φ. Dépasser 1,96 en valeur absolue conduit à rejeter l'hypothèse au niveau 5 %. Quand σ est estimé sur l'échantillon, la loi de Student remplace la loi normale.
Les erreurs classiques en colle et en copie
La première erreur concerne la notation. Écrire N(250, 8) en pensant à l'écart type alors que le cours pose N(μ, σ²) fausse tout le calcul. Précise systématiquement ce que désigne ton second paramètre.
La deuxième erreur porte sur les variances. Ajouter les écarts types d'une somme au lieu des variances est une faute fréquente. Retiens σ(X+Y) = √(σ₁² + σ₂²) dans le cas indépendant.
La troisième erreur touche la symétrie. Écrire Φ(-t) = -Φ(t) est faux, puisque Φ est à valeurs dans ]0, 1[. La relation correcte est Φ(-t) = 1 - Φ(t) : la densité φ est paire, mais sa primitive Φ ne l'est pas.
Deux autres pièges reviennent. Oublier l'indépendance avant d'additionner deux lois normales invalide la conclusion, et appliquer le théorème central limite sans variance finie n'est pas légitime.
Ce qui relève du programme de terminale
La distinction vaut d'être posée clairement. Le programme de spécialité mathématiques de terminale générale est fixé par arrêté du 19 juillet 2019, publié au Bulletin officiel. Sa partie probabiliste porte sur la loi binomiale, les sommes de variables aléatoires, la concentration et la loi des grands nombres. La loi normale n'y figure pas parmi les contenus.
Les générations antérieures l'ont pourtant étudiée en terminale scientifique. Beaucoup de ressources anciennes datent de cette période, ce qui explique la confusion courante.
Un point de calendrier mérite attention. Un arrêté du 26 février 2026, publié au Journal officiel du 27 mars 2026, fixe de nouveaux programmes de mathématiques pour la terminale générale. L'entrée en vigueur est annoncée à la rentrée 2027-2028, et le détail des contenus figure en annexe. Cette annexe n'a pas pu être consultée ici, donc vérifie au Bulletin officiel si la loi normale y réapparaît.
Ce qui relève de la prépa, filière par filière
En MPSI et en PCSI, l'enseignement des probabilités reste centré sur les univers finis. Les variables aléatoires à densité, et donc la loi normale, ne font pas partie du programme de première année. La loi normale y apparaît surtout par la physique, à travers le traitement des incertitudes de mesure.
En deuxième année de filière scientifique, le cadre s'élargit aux variables aléatoires discrètes infinies. L'étendue du traitement réservé aux lois à densité varie selon la filière et selon la version du programme. Appuie-toi sur l'annexe officielle de ta voie.
En ECG, la loi normale est traitée frontalement. Le programme de mathématiques approfondies de deuxième année comporte les variables aléatoires à densité et leur fonction de répartition. Il comporte aussi les lois usuelles dont la loi normale, la convergence en loi, le théorème limite central et l'estimation par intervalle de confiance.
En BCPST, la statistique appliquée occupe une place notable, en cohérence avec les usages des sciences de la vie et de la Terre. La loi normale, ses approximations et les intervalles de confiance y sont mobilisés. L'annexe du programme en vigueur reste la seule référence pour le détail des attendus.
Conclusion
La loi normale tient dans une formule et deux paramètres. La densité f(x) = (1/(σ√(2π)))·exp(-(x-μ)²/(2σ²)) fixe la forme, μ fixe la position et σ fixe la dispersion. Tout le reste en découle : la symétrie, les points d'inflexion en μ ± σ, l'aire unité, l'espérance et la variance.
La méthode de calcul tient en trois gestes. Tu écris l'événement, tu centres et réduis avec Z = (X - μ)/σ, puis tu lis Φ sur une table ou sur ta calculatrice. Entraîne-toi sur des énoncés aux bornes non symétriques, et retiens les valeurs à 1σ, 2σ et 3σ ainsi que les quantiles 1,645, 1,96 et 2,576.
Reste la culture du chapitre : stabilité par somme, théorème central limite, approximations de la binomiale et de la loi de Poisson, intervalles de confiance et tests.
Travaille tes concours avec un mentor et transforme ces connaissances en points, avec ViragePrépa.




Cet article vous concerne ? Parlons-en 15 minutes.
On analyse la situation de l'élève et on vous dit franchement où il peut viser. Gratuit · Sans engagement · 7j/7